Continuum
Überprüfbares Gedächtnis für KI-Coding-Assistenten
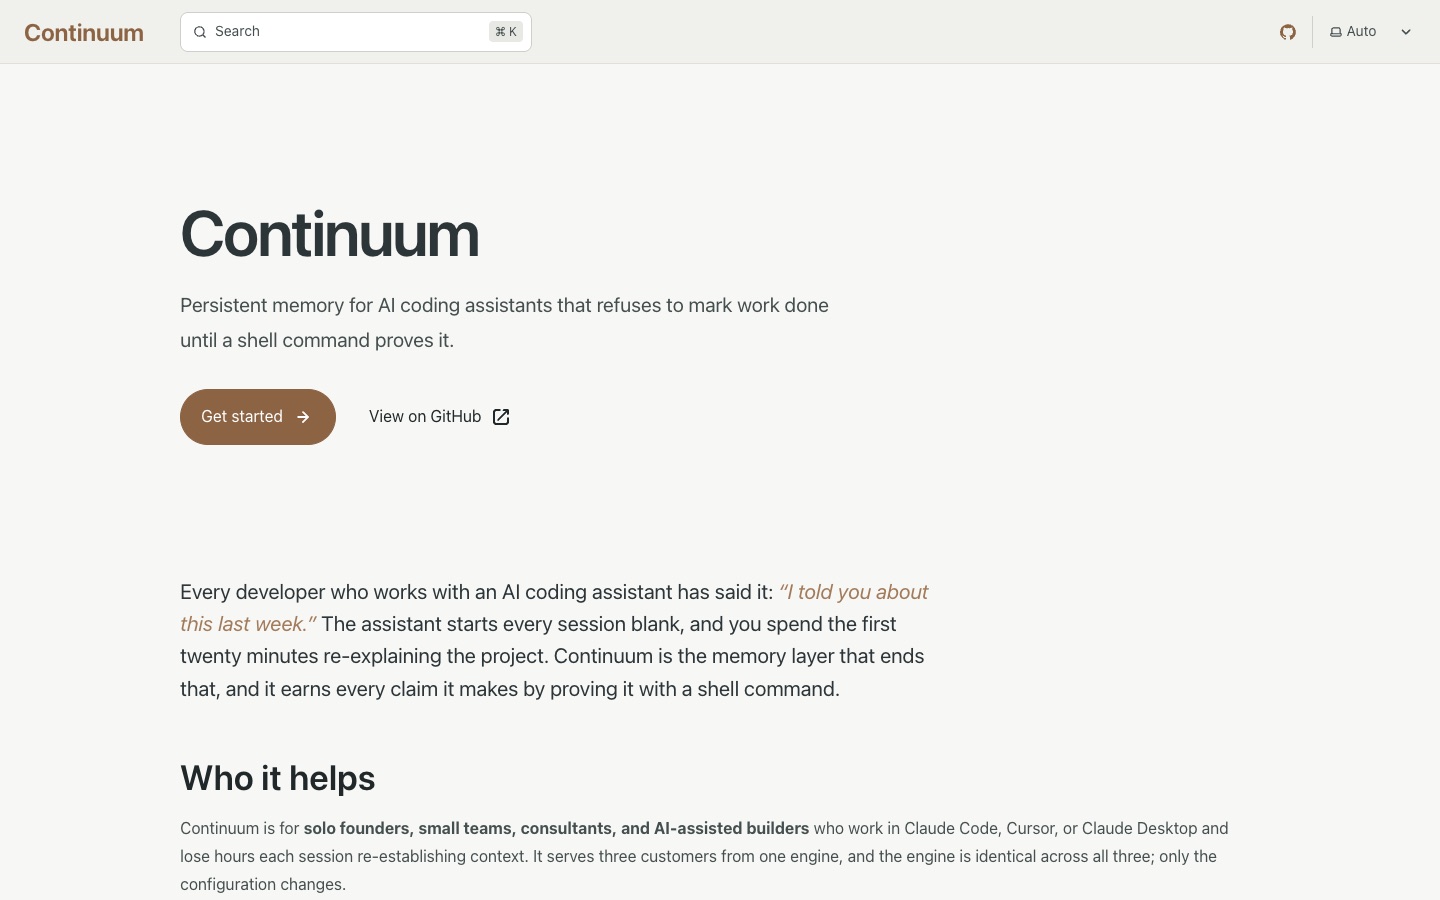
Für: Solo-Gründer, kleine Teams, Berater und alle, die mit KI-Unterstützung in Claude Code, Cursor oder Claude Desktop entwickeln; außerdem Produktteams, die mandantenbezogenes Gedächtnis einbetten.
Wer Software mit einem KI-Assistenten entwickelt, kennt die Routine: Jede Session beginnt bei null, und der erste Teil des Tages geht dafür drauf, erneut zu erklären, was ausgeliefert wurde, was kaputtging und was letzte Woche entschieden wurde. Continuum beendet das. Es läuft als Model-Context-Protocol-Server (MCP) neben dem Assistenten und hält ein dauerhaftes Gedächtnis des Projekts mit Checkpoints.
Es bündelt fünf Quellen der Projektwahrheit: lokale Dokumentation, Beobachtungen aus früheren KI-Sessions, menschliches Feedback, die Git-Commit-Historie und vollständige Session-Transkripte. Daraus entstehen ein Briefing, das der Assistent vor der ersten Antwort liest, zeitgestempelte Snapshots dessen, was aktiv, ruhend oder kaputt war, und eine laufende Liste offener Zusagen.
Was es unterscheidet, ist eine Regel namens Verify-then-dissolve. Eine Aufgabe in der Todo-Pipeline gilt erst dann als erledigt, wenn ihr Verify-Befehl erfolgreich beendet wird. Der Assistent kann nicht einfach behaupten, fertig zu sein; die Shell muss zustimmen.
Continuum richtet sich an Solo-Gründer, kleine Teams und Berater, die mit KI-Unterstützung ausliefern. Es wird über npm installiert, speichert Daten standardmäßig lokal, und dieselbe Engine lässt sich gehostet oder pro Mandant eingebettet in anderen Produkten betreiben.
~2,85x
weniger Retrieval-Tokens, gemessen an der eigenen Historie des Repos
5
Quellen der Projektwahrheit in einem Gedächtnis
Was es kann
Briefing zum Session-Start, damit der Assistent mit aktuellem Stand, offenen Todos und jüngstem Fortschritt beginnt
Bündelung aus fünf Quellen: Dokumentation, Beobachtungen aus dem KI-Gedächtnis, menschliches Feedback, Git-Historie und Session-Transkripte
Verify-then-dissolve: Ein Todo wird erst geschlossen, wenn sein Verify-Befehl mit 0 endet (continuum verify)
Dreistufige Progressive Disclosure (Suchindex, Timeline, vollständiger Abruf per ID), um den Token-Verbrauch gering zu halten
Nur anhängbare, per Hash versiegelte Zustands-Checkpoints, die sich nach Datum abfragen lassen
Datenschutzfilter, der API-Keys, Tokens und personenbezogene Daten bereits bei der Aufnahme entfernt, bevor etwas geschrieben wird
Hook-gesteuerte Erfassung aus den Lifecycle-Events des KI-Clients, ganz ohne manuelle Notizen
Operator-Konsole mit einer 3D-„Brain“-Ansicht des Gedächtnisses und Dossiers pro Knoten
So haben wir es konzipiert
- TypeScript
- Node.js
- Model Context Protocol SDK
- SQLite (better-sqlite3, FTS5)
- RuVector
- Transformers.js (MiniLM embeddings)
- Express
- jose (JWT)
- Next.js
- React
- Three.js / react-force-graph-3d
- Mermaid
- Vercel AI SDK
- Anthropic Claude
- Astro Starlight
- Docker
- Fly.io
- Vercel
- 01
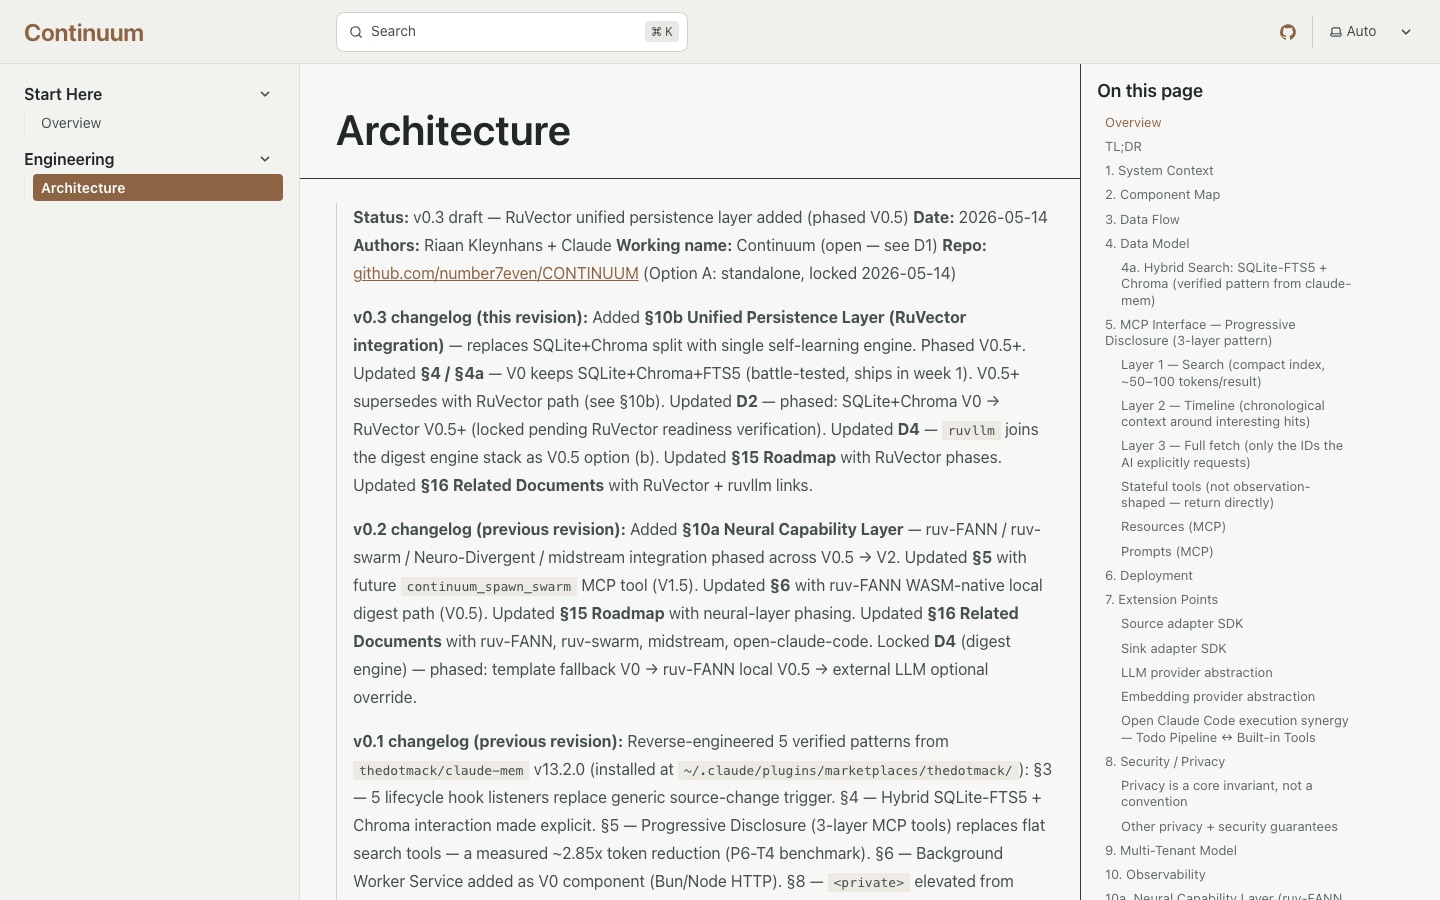
Monorepo aus TypeScript-Paketen: core (Speicher, Typen, Checkpoint-Engine, Datenschutzfilter), mcp-server, cli und Quell-Adapter für Dokumentation, Git, Remote-Git und Export
- 02
Der MCP-Server stellt Tools, Ressourcen (continuum://…) und Prompts über stdio für die lokale Nutzung oder über HTTP/SSE für Remote- und gehostete Nutzung bereit
- 03
Die Aufnahme wird durch Lifecycle-Hooks des KI-Clients gesteuert (SessionStart, UserPromptSubmit, PostToolUse, Stop, SessionEnd); jede Eingabe wird in einen einheitlichen Observation-Datensatz normalisiert und auf einem einzigen Schreibpfad durch den Datenschutzfilter geleitet
- 04
Der Speicher liegt hinter einer einzigen StorageBackend-Schnittstelle: SQLite mit FTS5-Stichwortsuche sowie ein Hybridmodus, der semantische Suche mit RuVector-HNSW über MiniLM-Embeddings ergänzt
- 05
Data Plane pro Mandant (eine SQLite-Datei und ein Vektorindex pro Workspace) mit einer geplanten schlanken Postgres-Control-Plane für Verzeichnis, Auth und Abrechnung
- 06
Die gehostete Engine läuft als Docker-Container auf Fly.io (continuum-engine) mit persistentem Volume; der Remote-Zugriff ist per Bearer-Token oder JWT geschützt
- 07
Die Next.js-Operator-Konsole und die Astro-Starlight-Dokumentation werden auf Vercel deployt; die Konsole spricht über den HTTP/SSE-Transport mit der Engine und nutzt Anthropic-Modelle für ihre Fragefunktion
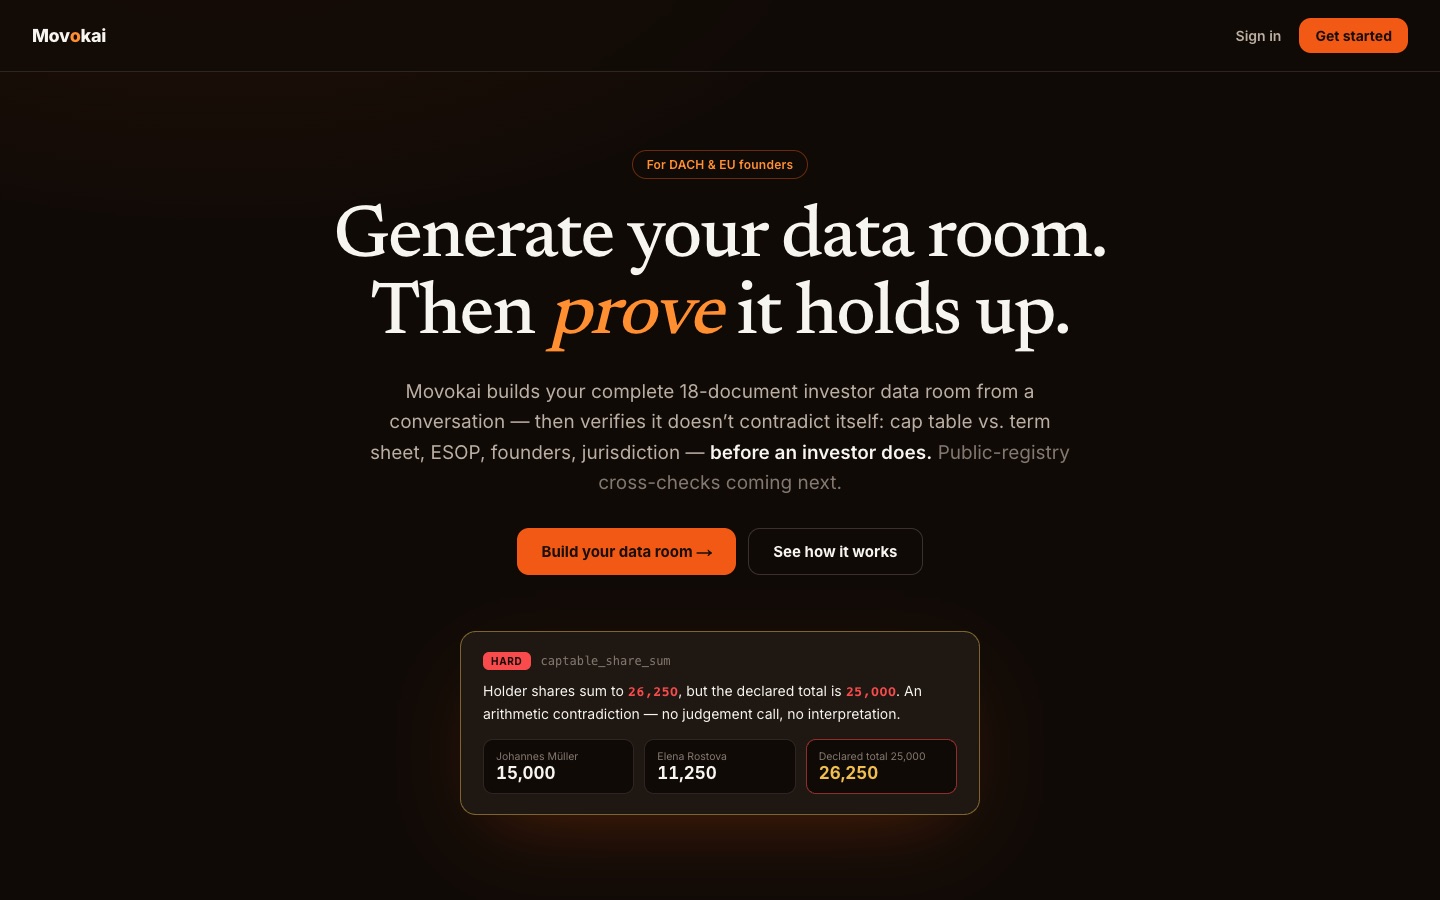
Sie möchten etwas Vergleichbares bauen lassen?
Jedes Projekt durchläuft dieselben fünf Gates: Spezifikation, Architektur, Build, Review, Auslieferung. Es beginnt in unserem Konfigurator.